2026.07.24 · vlm · fine-tuning
fundus-vlm — 오픈 VLM으로 안저 스크리닝 리포트 만들기
오픈 VLM의 안저 판독 능력을 정량 측정하고, QLoRA로 전문 CNN급까지 끌어올리고, 구조화 리포트 생성·서빙까지 — 공개 데이터만으로
ko-chart-vlm을 끝내고 나니 자연스럽게 다음 질문이 생겼습니다. "측정하고 → 약점을 겨냥해 데이터를 만들고 → 파인튜닝하고 → 서빙한다" — 이 사이클이 차트 말고, 진짜 내 도메인에서도 통할까?
저는 5년 넘게 안저(fundus) 영상을 다루는 AI 모델을 만들어 왔습니다. 시험대는 정해져 있었죠: 컬러 안저 사진. 대신 규칙을 하나 세웠습니다 — 공개 데이터셋만 씁니다 (APTOS 2019 · Messidor-2 · IDRiD · REFUGE · ODIR-5K · RFMiD, 총 ~31GB). 누구든 결과를 재현할 수 있어야 하고, 내부 데이터는 단 한 장도 쓰지 않습니다.
결과부터 보여드리면:
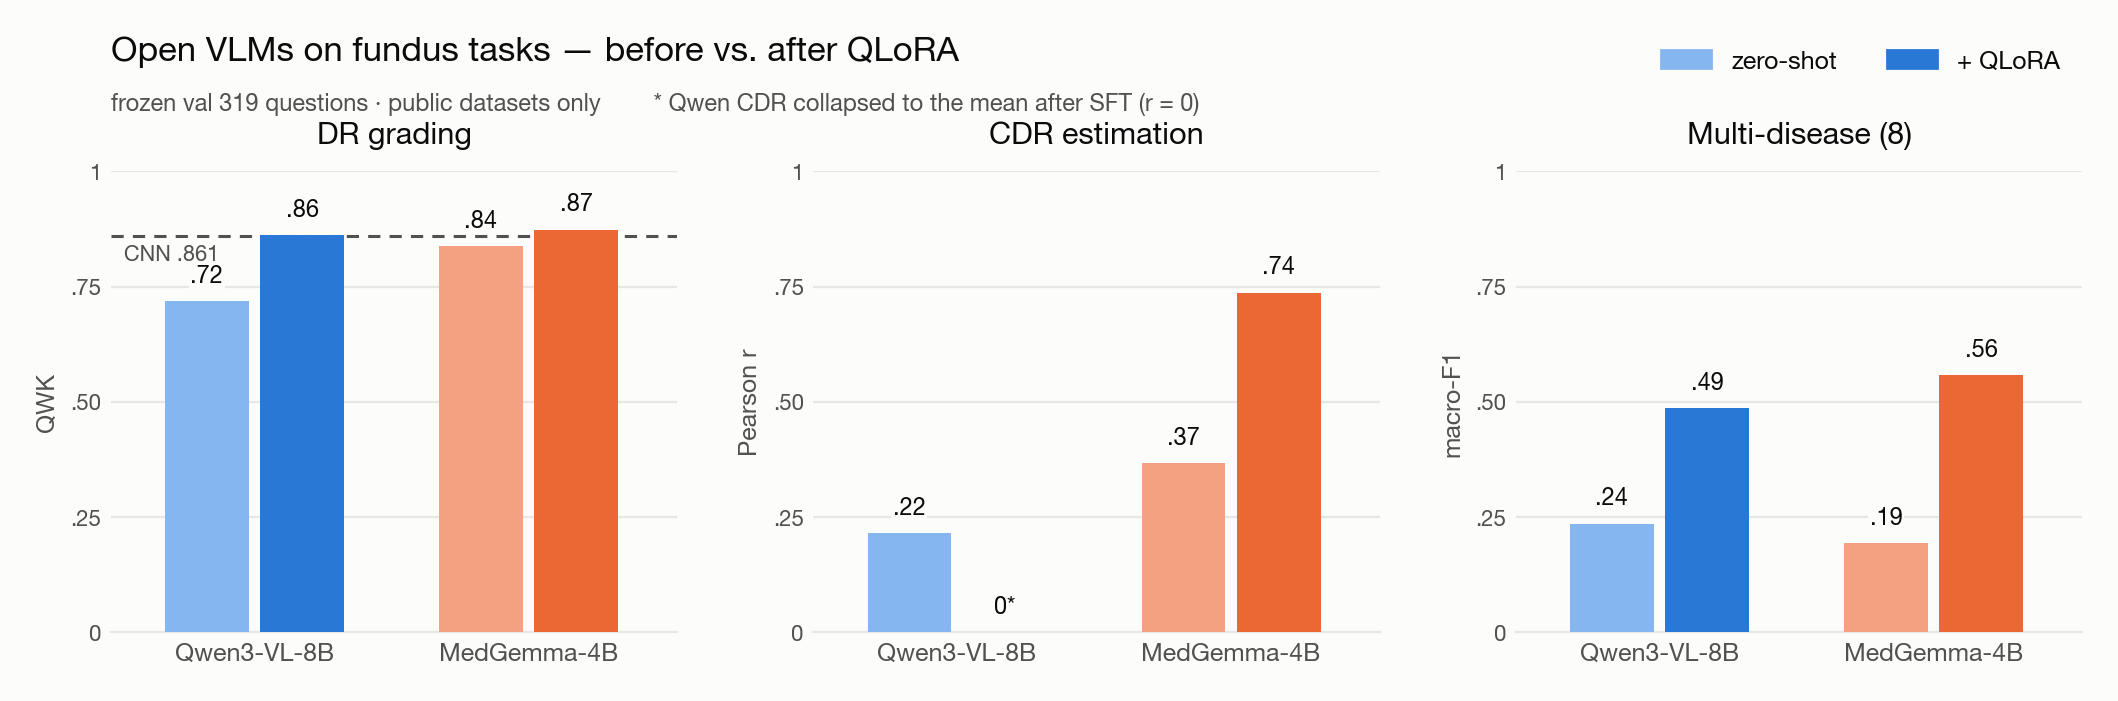
frozen val 319문항. 파인튜닝한 MedGemma-4B가 전 태스크 1위 — DR 등급에선 전용 CNN(점선, QWK 0.861)도 넘어섭니다.
오픈 VLM은 안저를 얼마나 읽을까
먼저 재봤습니다. Qwen3-VL-8B에게 진단 문항 170개를 던진 zero-shot 결과가 흥미로웠습니다:
- Mild DR 18장 중 0장 정답 — 전부 "정상"이라고 답했습니다. 초기 병변을 아예 보지 못하는 겁니다.
- 녹내장 5장 중 0장.
- CDR(수직 컵-디스크 비율, 녹내장 지표)을 물으면 어떤 사진을 보여줘도 0.5 근처의 상수를 답합니다(r=−0.14). 모르면 중간을 찍는 수험생 같았습니다.
의료 특화 모델인 MedGemma-4B는 어떨까요? DR 등급은 꽤 읽습니다(QWK 0.84 — 일반 8B보다 훨씬 낫습니다). 하지만 CDR은 r<0.4, 다질환 스크리닝은 macro-F1 0.19. 결론: 어떤 오픈 모델도 그대로는 부족하다. 대신 파인튜닝 헤드룸은 충분하다.
약점을 알았으니 데이터를 만든다
ko-chart-vlm에서는 정답을 계산할 수 있는 합성 차트를 만들었는데, 안저에서는 그럴 수 없습니다. 대신 공개 데이터셋의 전문가 라벨과 세그멘테이션 마스크가 그 역할을 합니다 — REFUGE의 disc/cup 마스크에서 CDR을 계산하고, ODIR의 질환 라벨로 구조화 리포트 템플릿을 채우는 식입니다. 정답이 사람 손이 아니라 데이터에서 나오니 환각이 낄 자리가 없습니다.
이렇게 val과 겹치지 않는 train 여집합에서 VQA + 리포트 6,528페어를 만들었습니다. 약점(초기 DR, CDR, 다질환)을 겨냥해 균형을 맞추고요.
여담이지만, 이 과정에서 데이터 검증노트 쓰는 습관이 값을 했습니다. 미러로 받은 APTOS 라벨이 클래스명 알파벳순으로 인코딩되어 있어서 임상 등급 순서와 달랐던 것 — 눈치 못 채고 학습했으면 등급이 뒤섞인 모델이 나올 뻔했습니다.
가장 재미있었던 발견 — 의료 사전학습이 분기점이다
QLoRA 파인튜닝(RTX 4090 한 장) 후, DR 등급과 다질환은 두 모델 모두 크게 올랐습니다. 그런데 CDR 정량 추정에서 두 모델의 운명이 갈렸습니다:
- Qwen3-VL-8B(일반): 학습 후 오히려 평균값으로 붕괴했습니다(r→0). 손실은 줄었는데 정보가 없는, 가장 허무한 형태의 실패입니다.
- MedGemma-4B(의료): 같은 340개 샘플로 r 0.368 → 0.737까지 실제로 배웠습니다.
같은 데이터, 같은 레시피, 같은 GPU입니다. 다른 건 사전학습뿐. 의료 시각 사전학습이 있어야 소량 데이터로도 정량 읽기를 배울 수 있다는 게 이 프로젝트에서 얻은 가장 명확한 교훈입니다. 혹시 입력 해상도 문제인가 싶어 disc 영역만 잘라 주는 ablation도 해봤지만 도움이 되지 않았습니다(음성 결과) — 원인은 눈이 아니라 뇌 쪽이었습니다.
덤으로, 최종 서빙 모델도 이 발견을 따라갑니다: 4B 의료 모델이 8B 일반 모델을 전 태스크에서 이겼습니다. 파라미터 수보다 사전학습 도메인이 중요했습니다.
전용 CNN과 비교하면?
"VLM 파인튜닝이 잘 됐다"는 주장에는 기준선이 필요합니다. 같은 데이터로 EfficientNet DR 분류기를 학습해 상한선을 재봤습니다: QWK 0.861. 파인튜닝한 MedGemma는 0.874 — 전용 CNN과 대등하거나 조금 넘습니다.
단일 태스크 정확도만 필요하면 CNN으로 충분합니다. 차이는 한 모델이 DR 등급·다질환·CDR·구조화 리포트를 동시에 처리하면서 말로 설명까지 한다는 점입니다. 스크리닝 리포트처럼 여러 판단을 묶어야 하는 자리에서 파인튜닝 VLM이 실용적인 선택지가 된다는 걸 수치로 확인했습니다.
이번에도, 실패까지 기록
ko-chart-vlm에서 가져온 실험 규칙 그대로입니다 — 실험 1건 = 디렉터리 1개(결과 jsonl + meta + report), 모든 주장은 수치로. 그래서 이번에도 잘된 것만 남기지 않았습니다: Qwen의 CDR 평균 붕괴, disc-crop ablation의 음성 결과, 남아 있는 약점(Moderate DR 혼동, hypertension 소견)까지 phase별 리포트에 다 있습니다.
- 저장소: anears/fundus-vlm — phase 0~6 리포트 · 데이터 검증노트 · Gradio 데모
- 선행 프로젝트: 한국어 차트를 못 읽는 VLM, 7일 만에 고치기
스택: Qwen3-VL-8B · MedGemma-4B · QLoRA(커스텀 트레이너) · vLLM · Gradio · uv